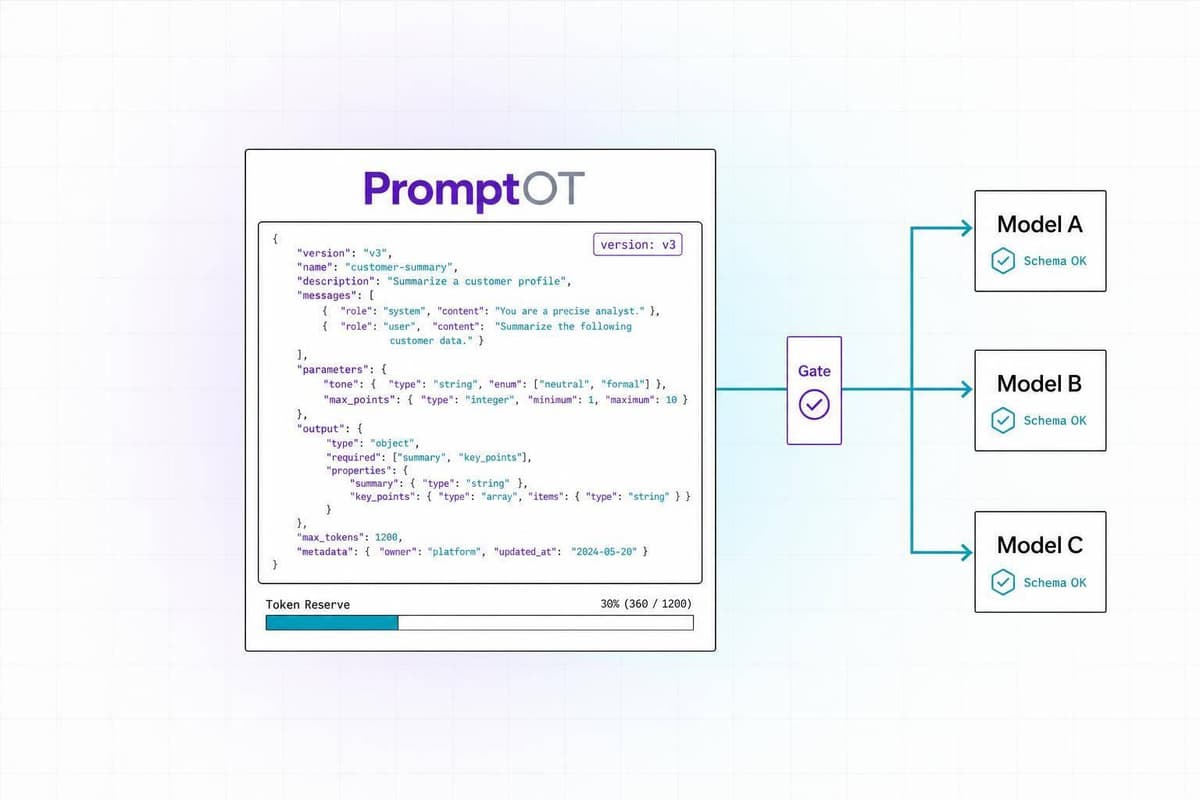
Multi-Model Prompt Compatibility: Guide to API Limits
Treat shared prompts as versioned execution specs: validate request shape, reserve tokens, test schemas, and gate rollouts across models.
Read moreBrowse all articles in the prompt engineering category.
Treat shared prompts as versioned execution specs: validate request shape, reserve tokens, test schemas, and gate rollouts across models.
Read more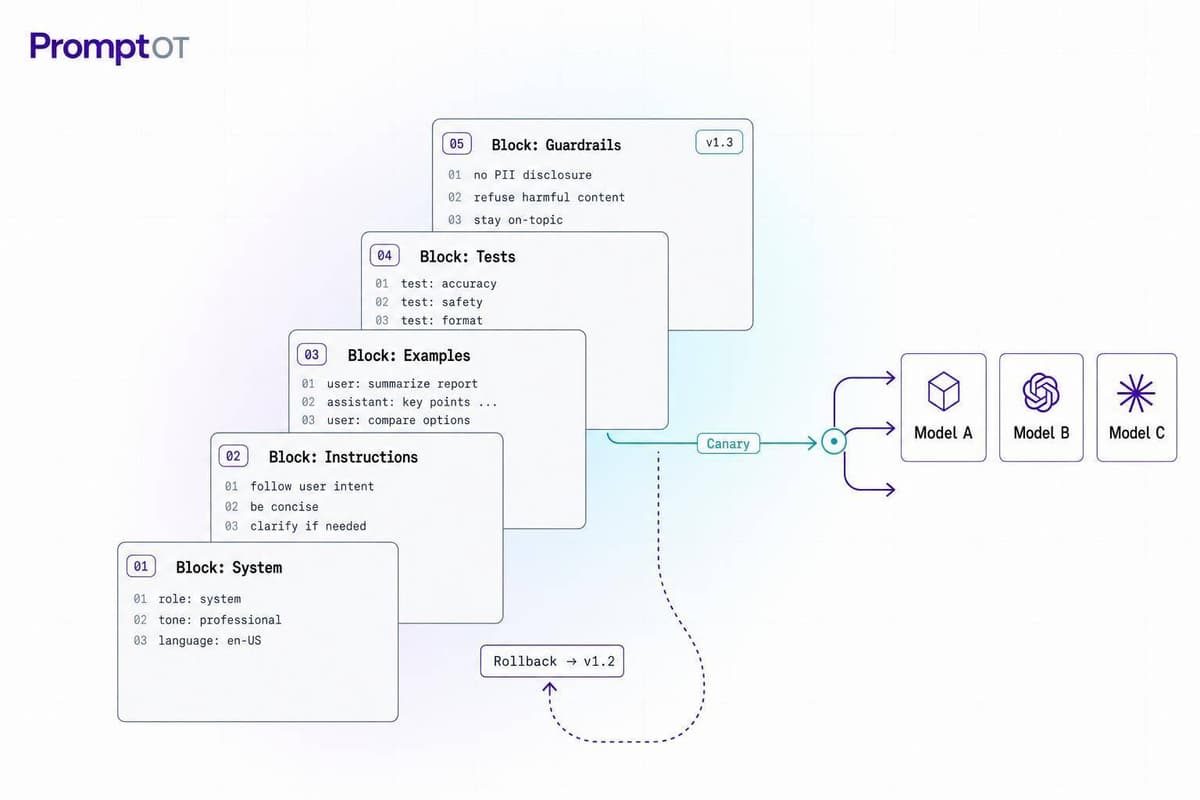
Treat prompts like code: structure prompts in reusable blocks, version and test across models, map providers, canary rollout, and fast rollback.
Read more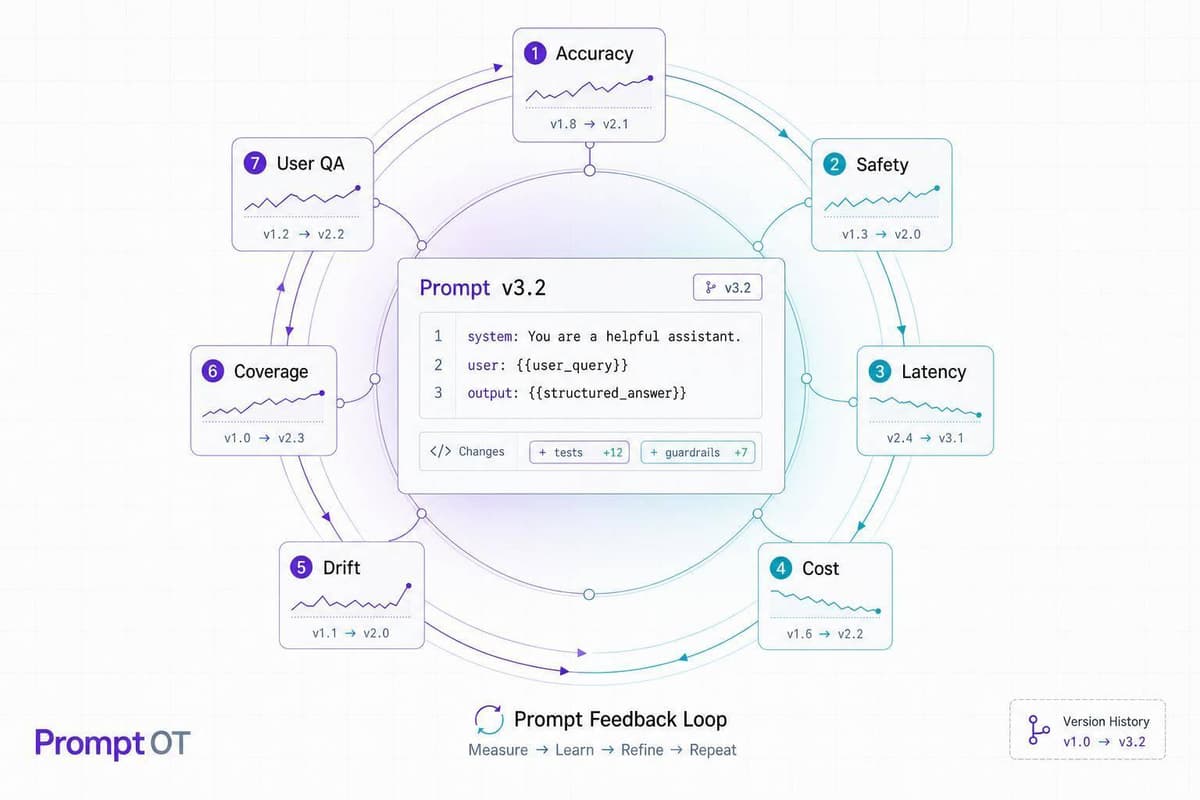
Make prompts production-ready with versioning, traceability, measurable signals, and seven feedback loops for safer updates.
Read more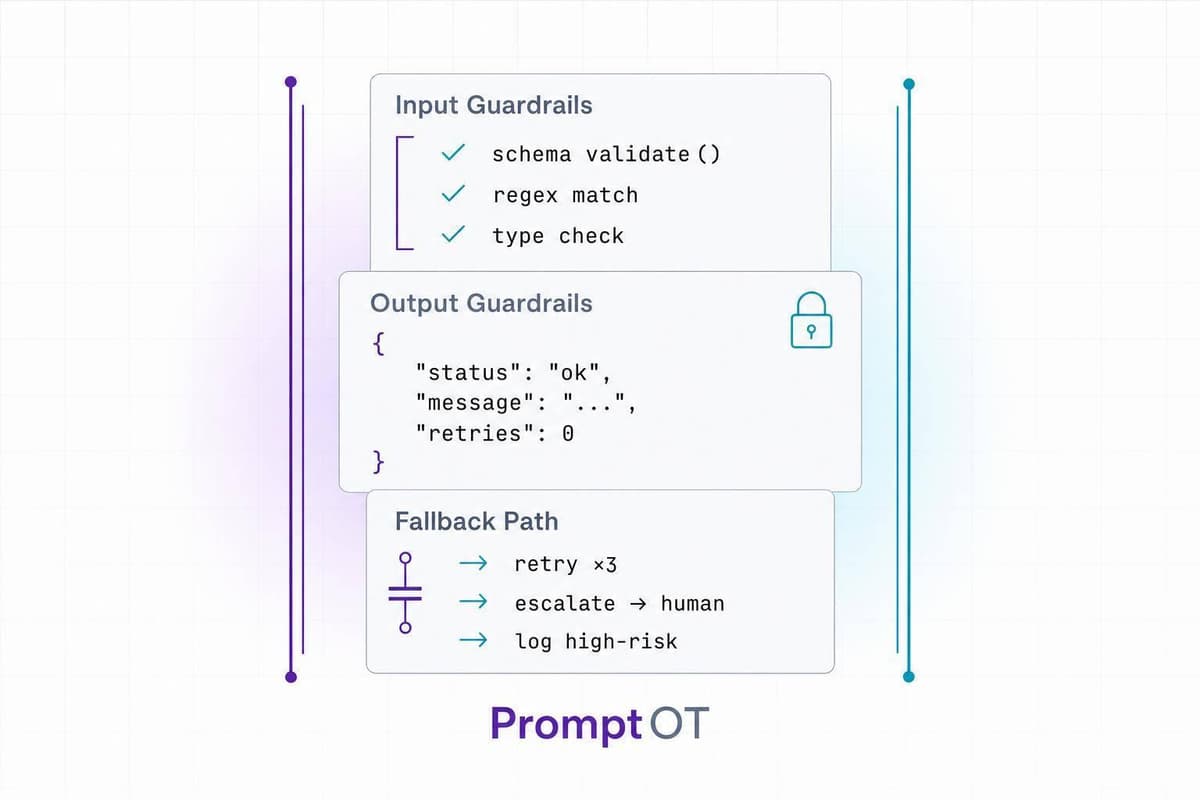
Split guardrails into input, output, and fallback: validate inputs, enforce JSON outputs, limit retries, and escalate high-risk cases.
Read more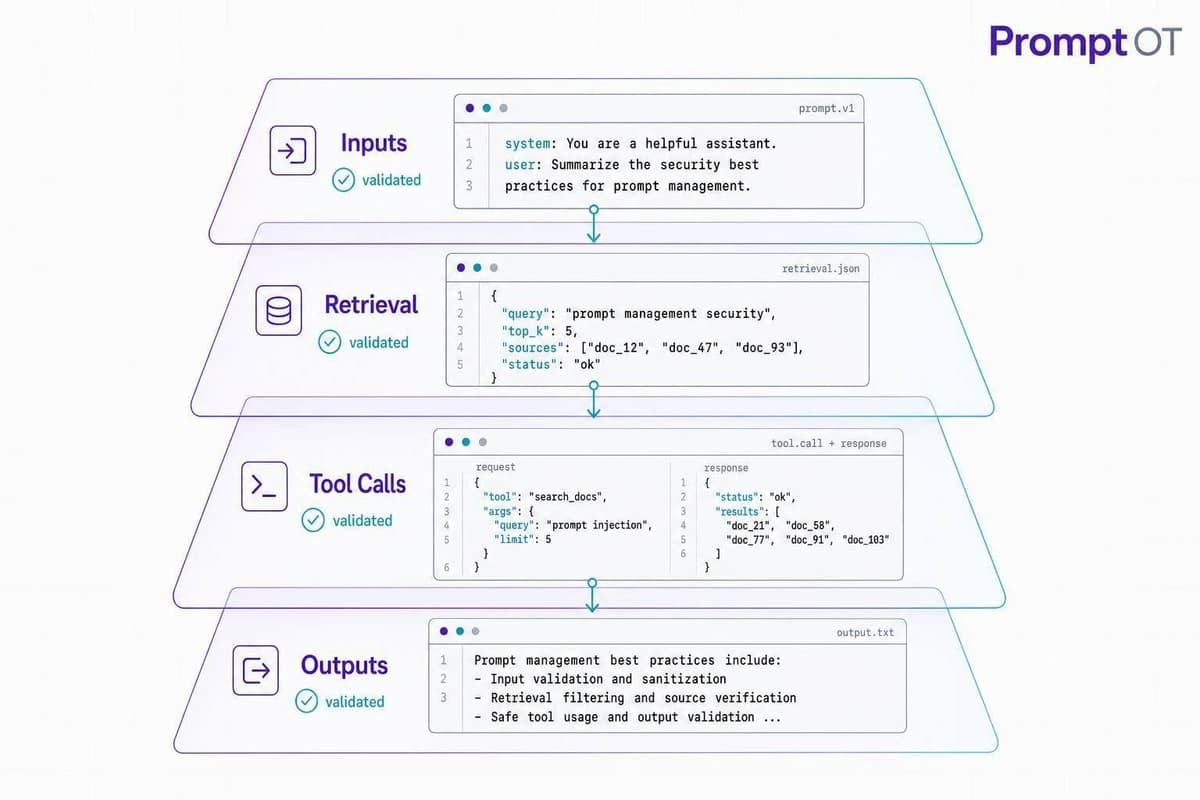
Layer request-by-request checks across inputs, retrieval, outputs, and tool calls to prevent prompt injection and unsafe actions.
Read more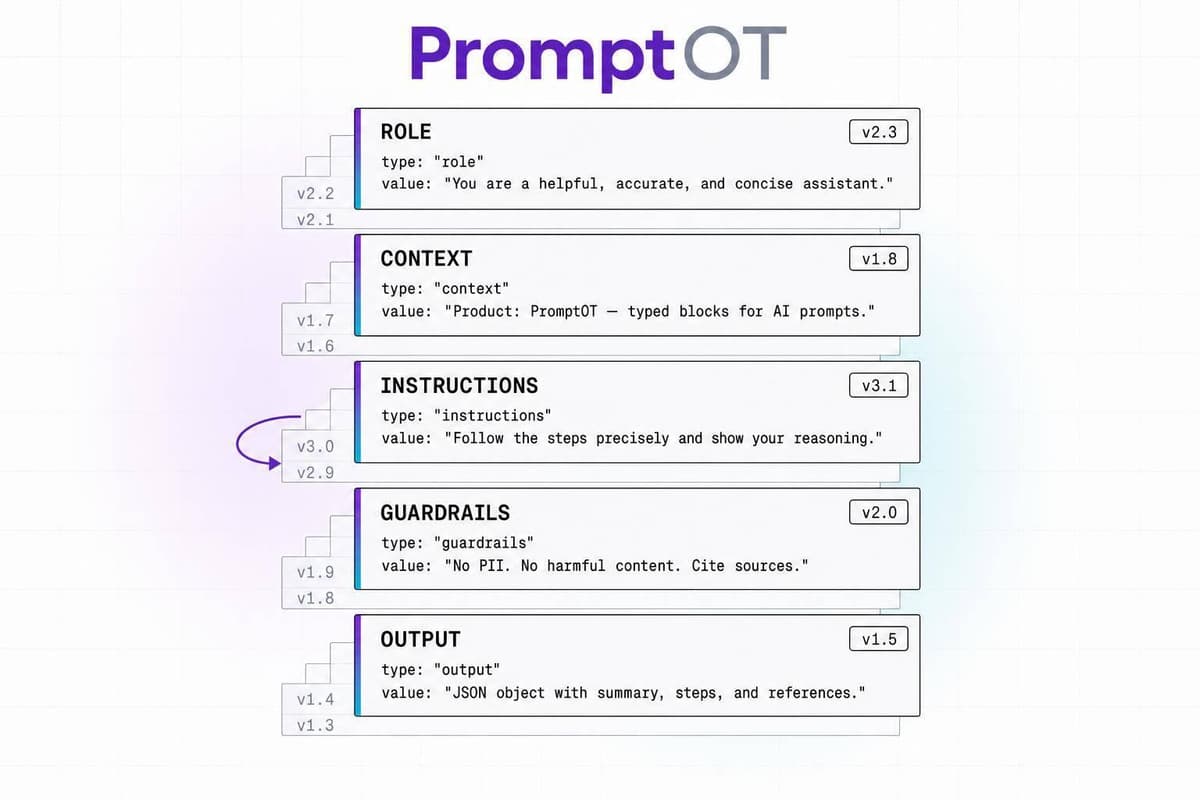
Treat prompts like releases: version typed blocks (role, context, instructions, guardrails, output) for quick rollback and auditable safety.
Read more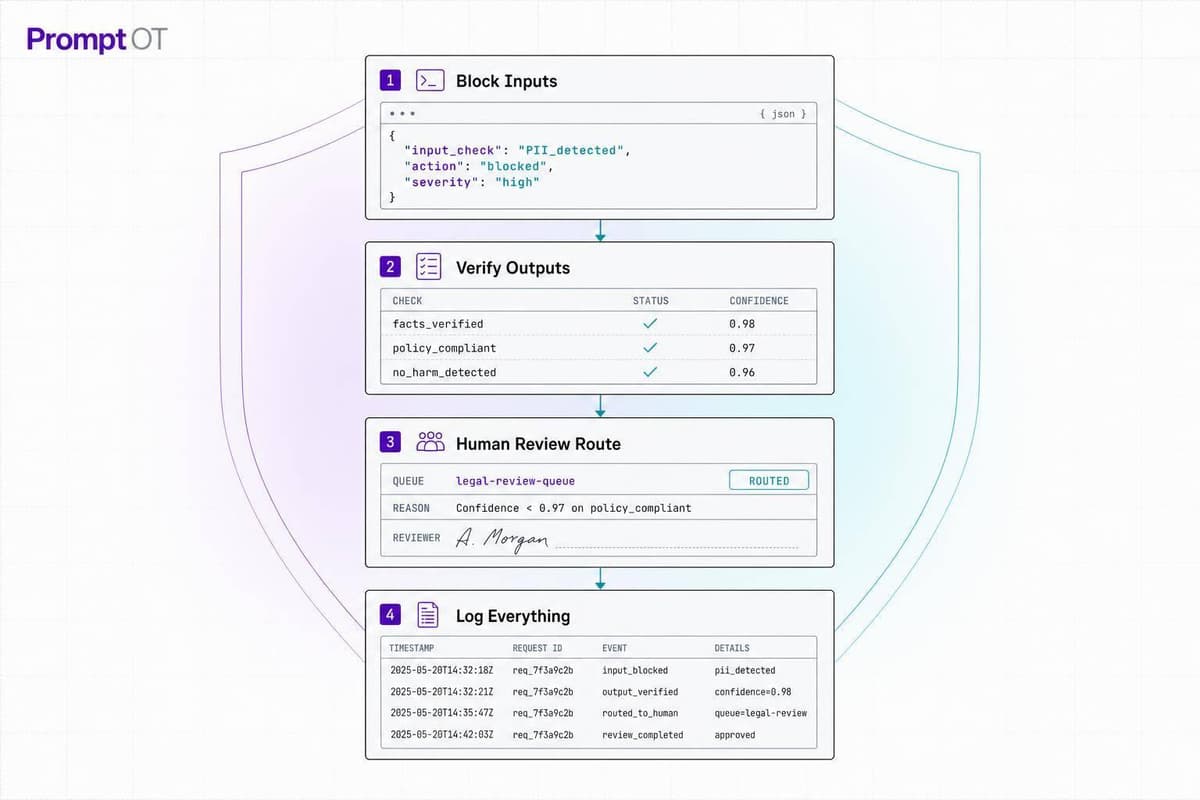
Runtime controls — not policies — make legal AI defensible: block inputs, verify outputs, route to human review, and log everything.
Read more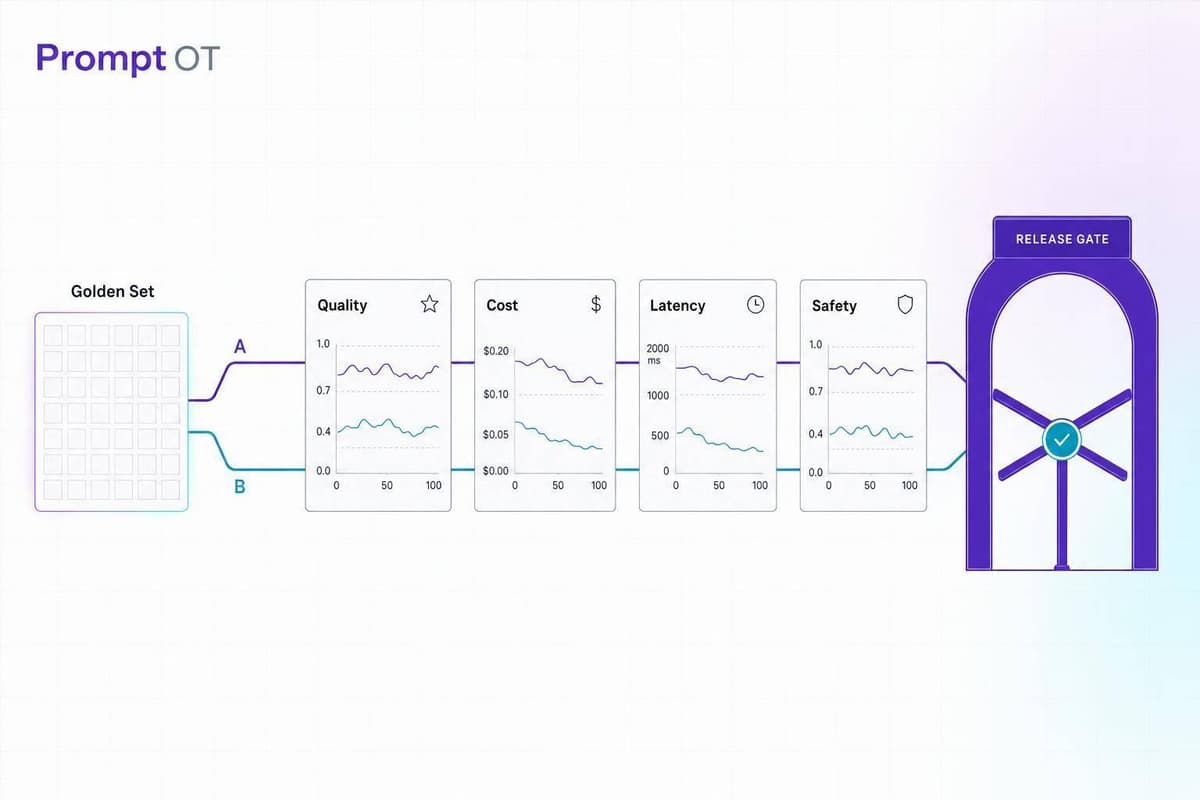
Test prompts on a golden set with 3–5 metrics (quality, cost, latency, safety), use paired tests or A/B, and enforce release gates before shipping.
Read more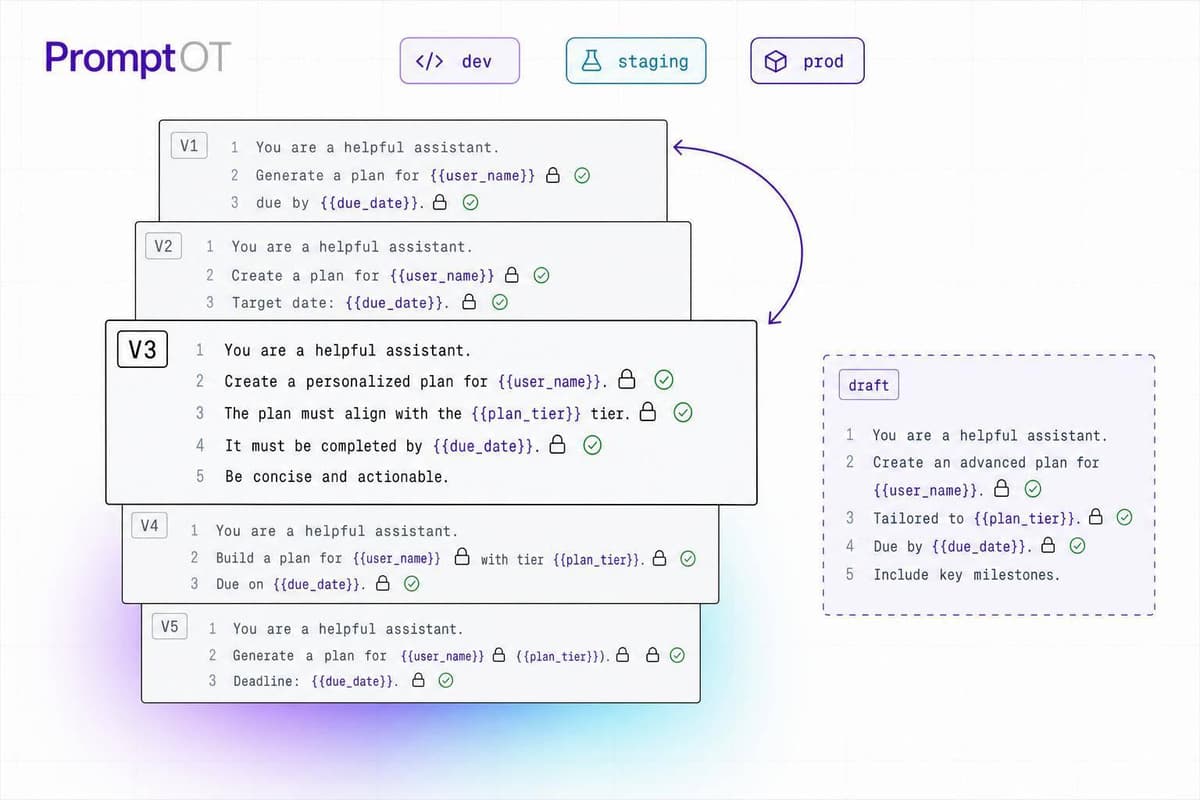
Treat prompts as versioned config: lock variable contracts, validate inputs, separate drafts, check envs, and enable rollback.
Read more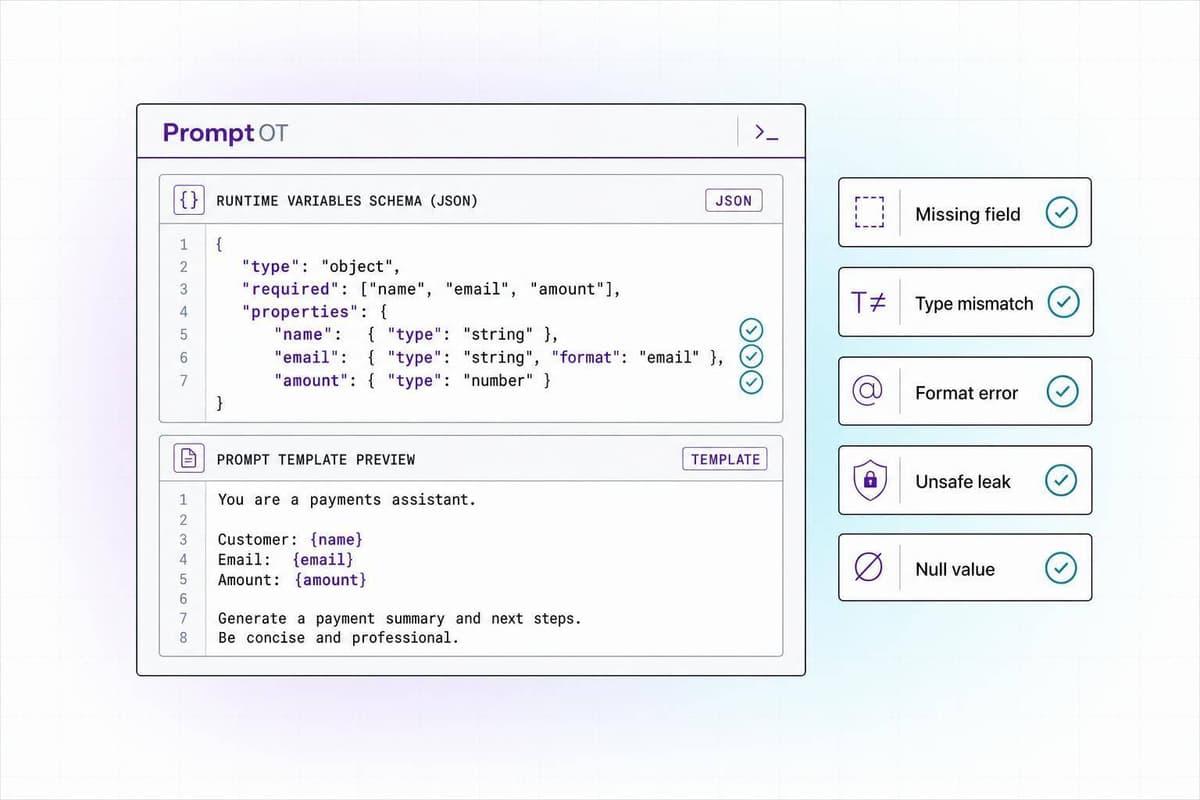
Treat runtime prompt variables like typed, validated inputs to avoid missing fields, leaks, and formatting errors.
Read more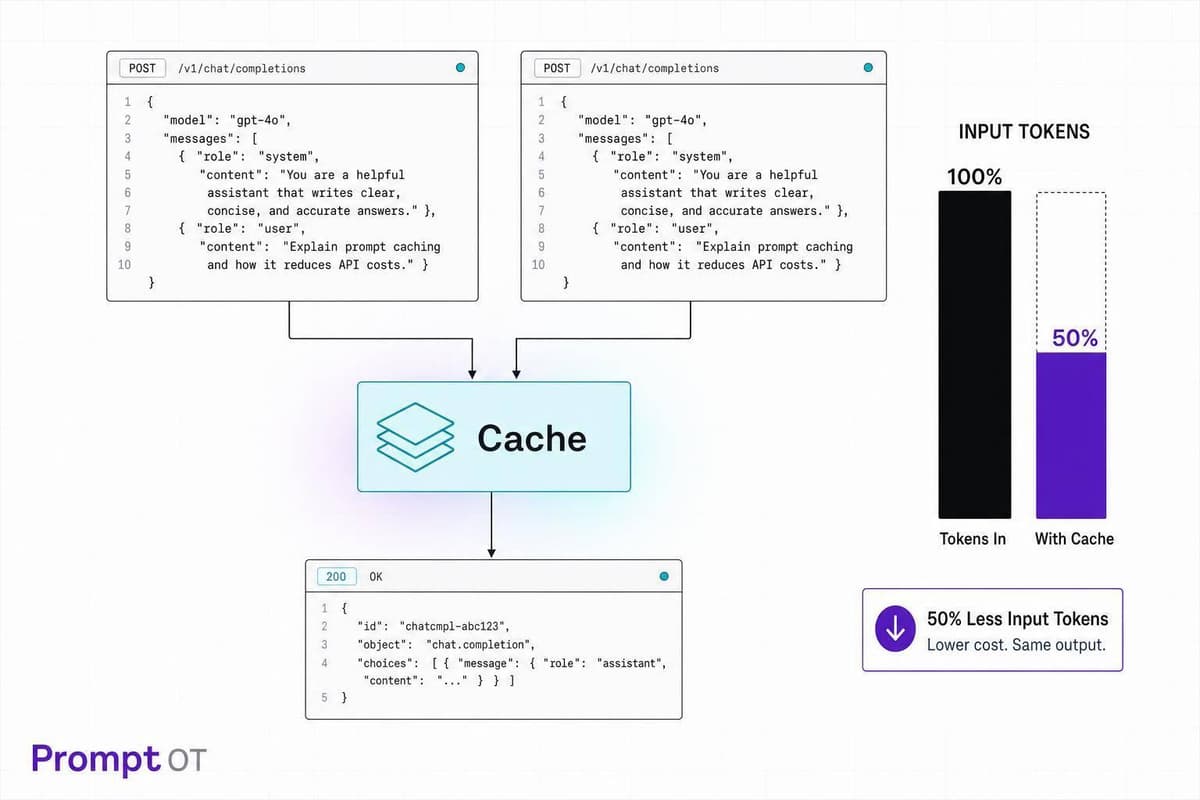
Keep prompt fronts identical to cut LLM API costs and latency—provider and app caching can halve input spend.
Read more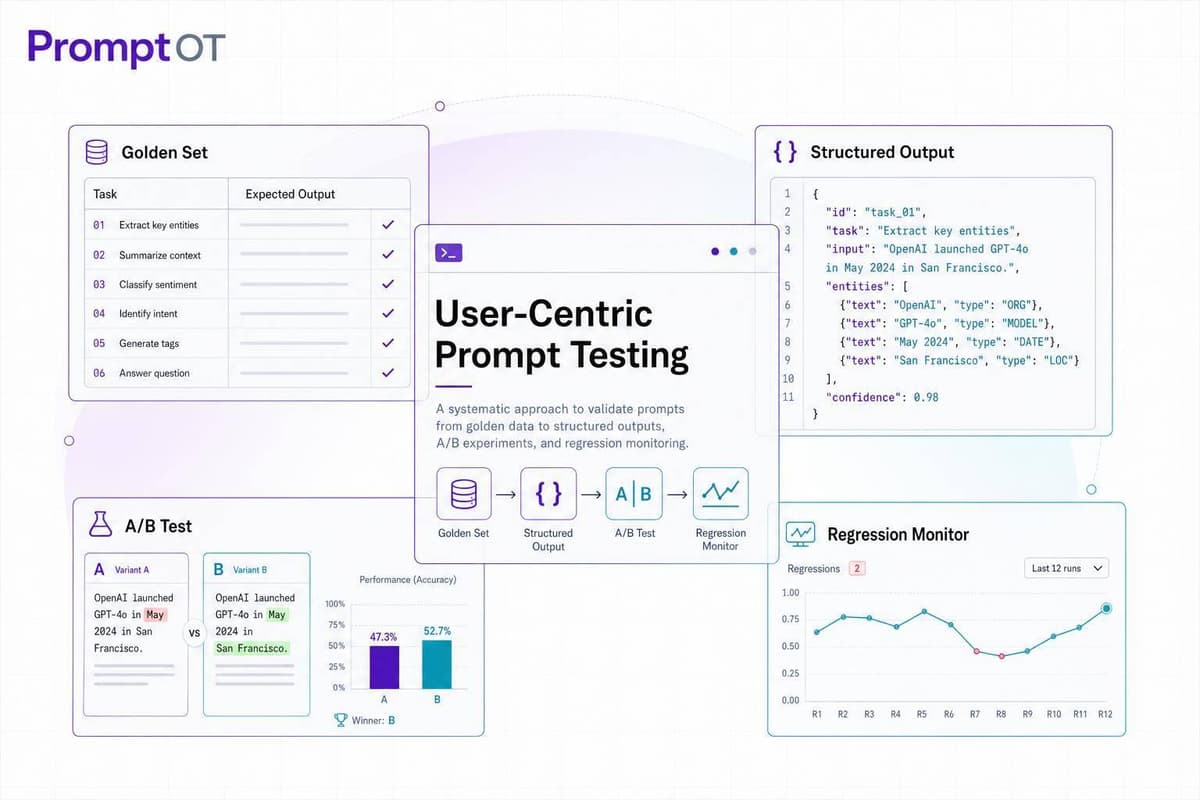
Test prompts against real user tasks: build a golden set, use structured outputs, run controlled A/B tests, and monitor regressions.
Read more